Transforming Weather Data from Pixel to Latent Space
这应该算一篇论文解读。关于为什么解读这一篇,一方面是我最近研究了一段时间的diffusion model,顺带就看了看VAE。这篇文章增进了我对于VAE的理解;另外一方面是,这篇文章给了我很多启发,让我意识到了很多事情的可行性,得以展开一些新的研究。当然还有一些杂七杂八的因素,比如它是ICML oral,比如是我的一个mentor将这篇文章发给了我,比如它是气象学相关的研究。
需要声明的是,这篇文章的作者团队在deep learning和气象学领域的知识都远超于我,我只能力所能及地解读部分我关注的知识,不过幸运的是,这正好是这篇文章的关键思想。原文链接:https://arxiv.org/abs/2503.06623
一、背景。
此工作基于三个痛点开展。
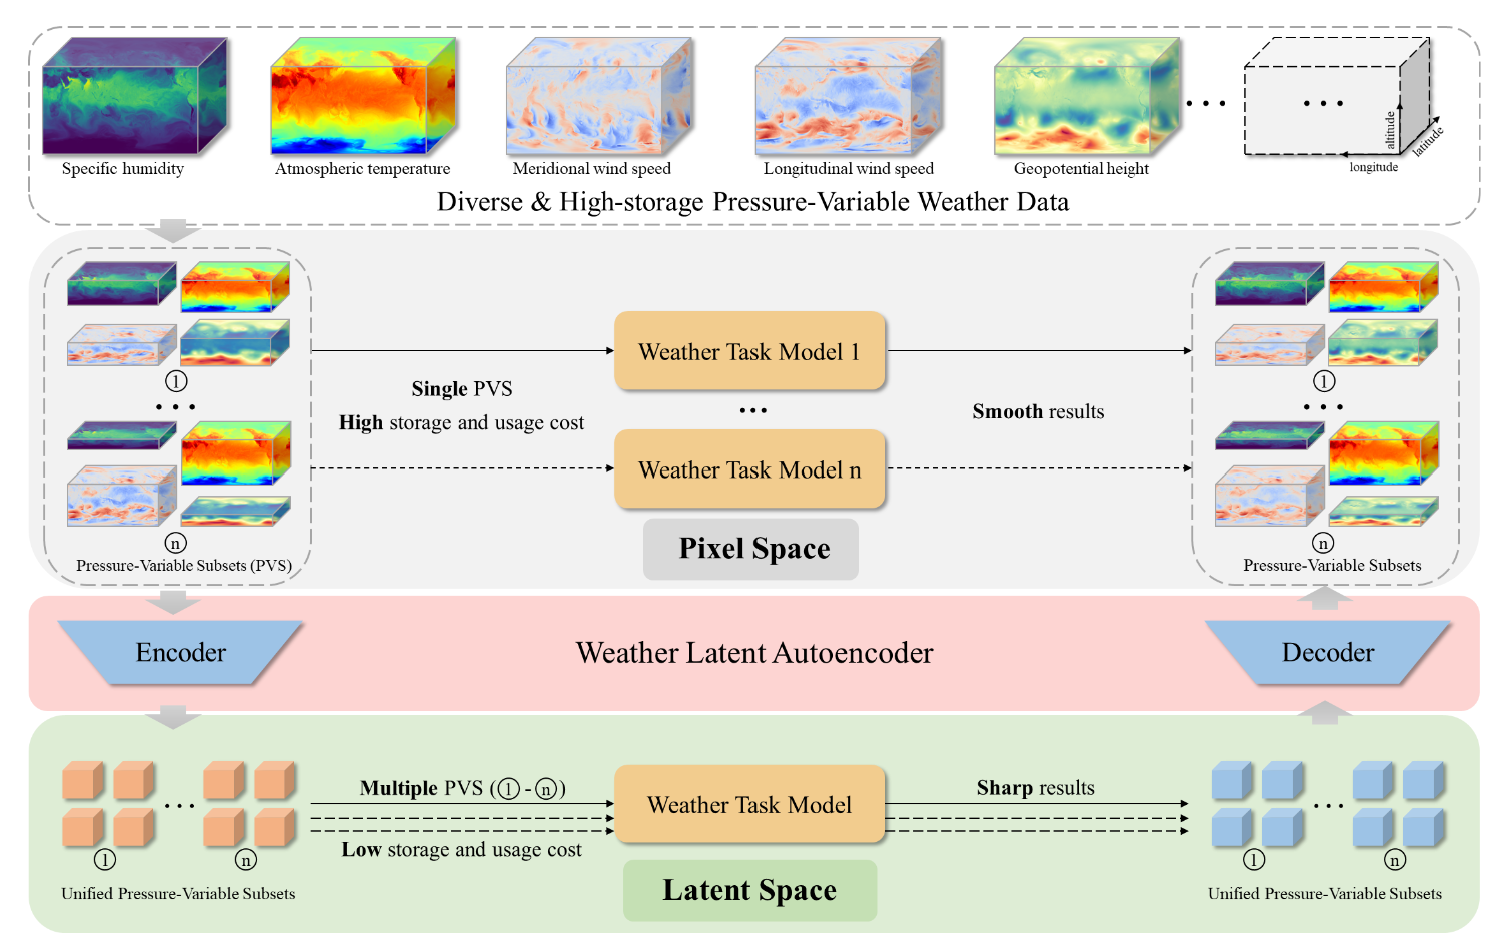
- 1.像素空间的任务模型输出过于平滑——因为模型在做预测的同时还要承担"重建",任务不确定性会把局地强降水、台风气压梯度这类小尺度极值抹掉;
- 2.模型通常绑死在单一气压变量子集(PVS)上,换任务就得换模型;
- 3.是存储成本——完整 ERA5 有 244.34 TB。
最关键的是痛点1,刚好也与我的工作有适当的交集。痛点2更多是为我提供了一种可行性的暗示。痛点3我完全不懂,大概率不会解读。
输出的平滑性是由MSE这类逐点损失训练导致的。面对不确定性,最优解是输出所有可能未来的平均。而多个锐利场的平均是一个模糊场。于是小尺度极值被系统性地抹平。简而言之,损失函数在不确定性面前奖励模糊,就是“输出过于平滑”的根源。
以下是将上述问题与任务匹配的实例说明。由此能引出作者的idea。否则有点突兀。
假定预报模型承担了这样一个任务:看过去两天的台风位置,预测明天的台风位置,必须交付一张完整的像素图,每个格点要有一个数字。
模型非常清楚明天有两种可能:台风在A处(50%),或在B处(50%)。但他只能交一张图。
模型有两种画法:
- 画法一(下注):赌一边,比如在 A 处画一个完整、锐利的台风。
- 画法二(对冲):在 A 和 B 各画半个强度的、边缘发虚的"半台风"。
模型的绩效按照MSE算。显然,画法二的收益更大,然而它实际上是平滑后的、不正确的预测。
模型的这份工作分为两个环节,一个是“预测”,即预测明天台风的位置;另一个是“重建”,即将气象场(这里是台风)画出来。在刚刚的例子中,模型的预测环节其实没有问题,它清楚“50% A、50% B”。问题出在重建环节,由于必须交付像素画,它将心里的概率变成了一张确定的像素图。它只能把两种可能"叠"着画,于是心里清醒的不确定性,落到像素上就成了模糊。
“预测的不确定性污染了重建的锐利度”翻译过来就是:判断环节里正常存在的“不确定”,经过“必须输出像素图”这道工序,变成了画面上的“模糊”。污染的通道就是模型承担的任务太复杂——预测和重建共用一个模型。
二、方法。
根据以上的场景,很自然地,作者提出了新的方法:将重建和预测任务解耦。
- 重建由预训练好的WLA(Weather Latent Autoencoder)来负责。其训练过程就是典型的Auto Encoder训练过程,在此不赘述。
- 预测由一个在潜空间训练的网络WTL(Window-ViT-Latent)负责。输入和输出都是潜token,在WLA的潜空间中运行。
由于WLA是一个纯粹的解码器,在预训练只见过真实气象场的Latent Embedding,它学到的映射是从任意合法token指向具有真实统计特征的气象场,模糊的像素输出在这个体系中是完全没有生成路径的。因此,像素的模糊被排除了。这个部分有使用GAN进行训练的功劳在。
三、问题。
我认为“解耦”这件事情本身是有问题的。原因在于,解耦后无法保证训练出来的autoencoder一定能提取出“利于预测任务”的表征。
神经网络之所以可训练,很大程度上取决于其所有参数都“服务于同一个目标”。当梯度经由反向传播到达各层,所有参数都会朝着一个共同的目标进行更新。网络整体具有高度的纪律性。
假如我们在“判断图片中的物品是不是猫”的任务中训练了一个autoencoder,随即冻结其参数,将其移用到“判断图片中的物品是不是狗”的任务中,只改变中间的在latent space中进行预测的模型,这个任务一定会是失败的,原因在于,基于第一个任务训练的autoencoder并不会自发地提取出用于“判断图片中的物品像不像狗”的表征。
在《Transforming Weather Data from Pixel to Latent Space》这篇文章中,autoencoder是基于GAN直接训练的,或许会赋予编码器更多的泛化性能,但是针对该下游任务,应该还是会出现上述问题,但可以将缺点从“不会自发提取”弱化为“无法充足保留”,但总之,这为该架构留下了优化空间。
JEPA或许会是该架构优化的一个方向。将预训练的encoder与初始化的预测模型结合,但不冻结参数,使用如下的训练架构,采用EMA(或是后续LeCun Yann提出的其他方法,我忘记了)对encoder参数进行更新,同时防止坍缩:
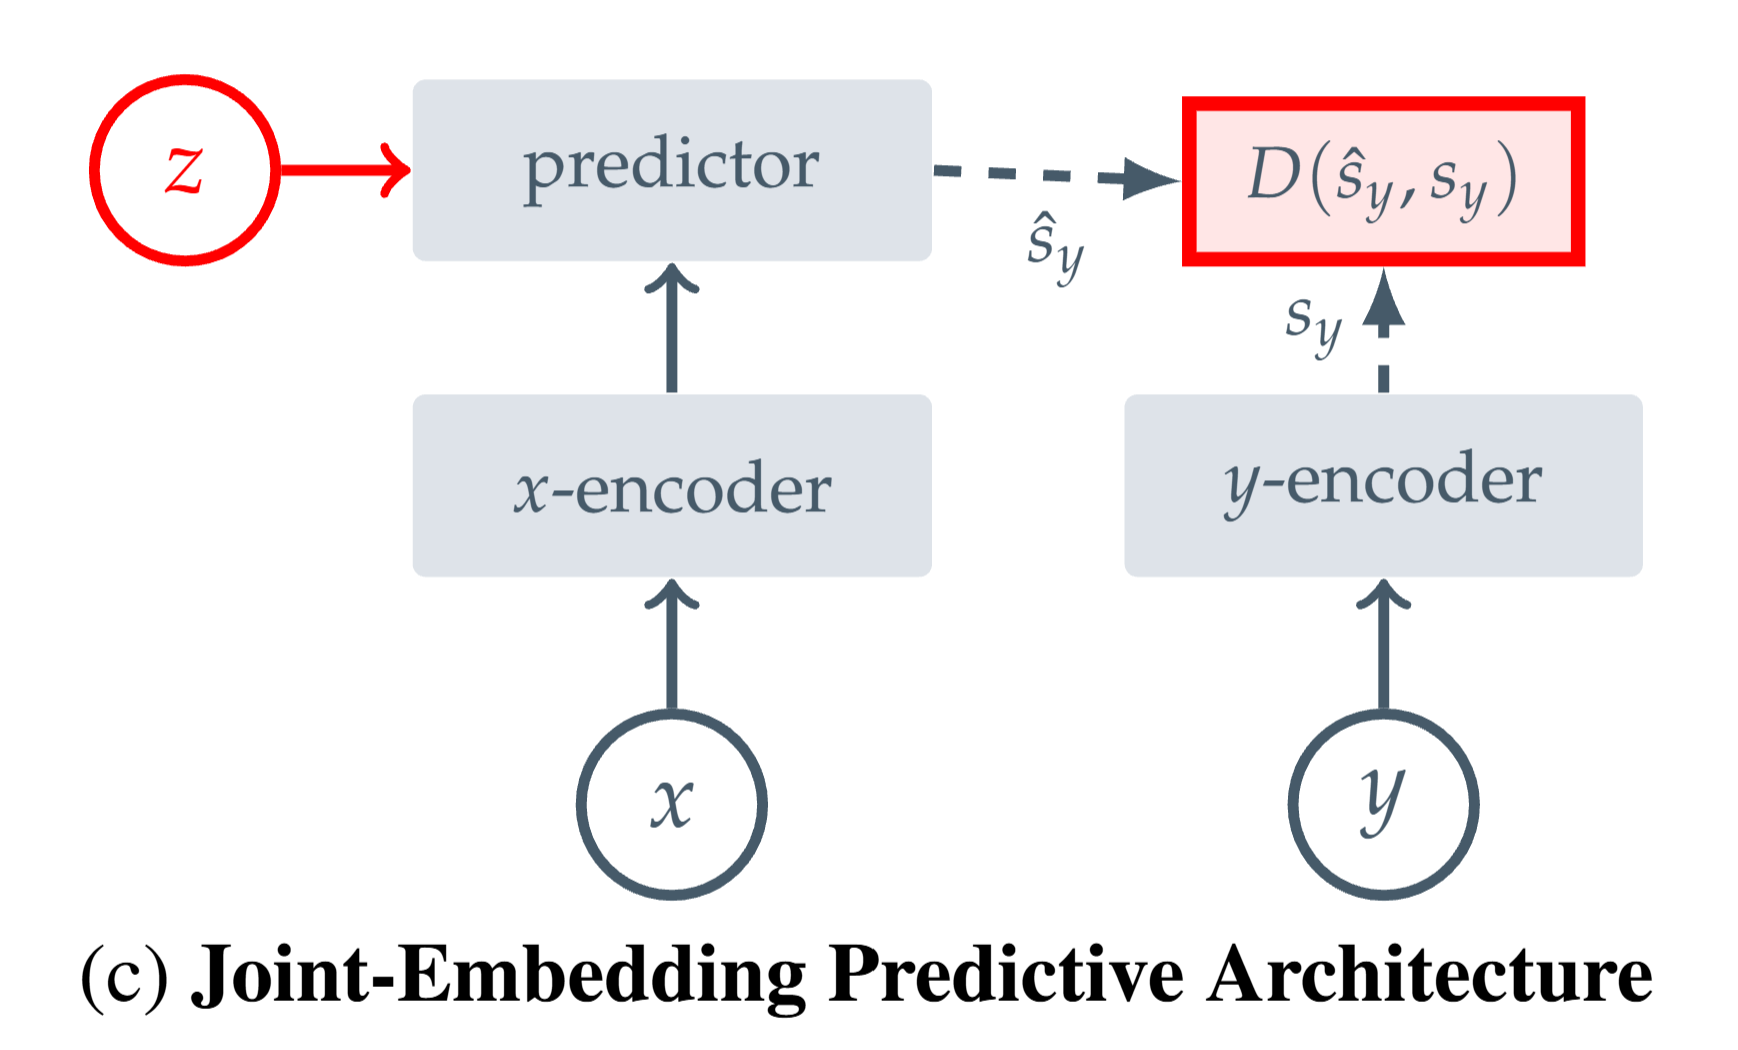
这或许会表现出更好的性能。因为encoder能意识到自己在为了什么工作服务。
四、另外的事。
过几天写一期diffusion吧。假如学成了的话。